数据结构与算法之美学习笔记
基础篇之排序优化
Table of contents
Open Table of contents
基础篇之排序优化
你知道如何实现一个通用的、高性能的排序函数?
在平时的开发中,我们经常直接使用平台编程语言所提供的排序函数,比如Java的Arrays.sort()方法,你知道这些排序函数是如何实现的吗?底层都利用了哪种排序算法呢?
如何选择合适的排序算法?
要实现一个通用的、高效率的排序函数,该如何选择排序算法?
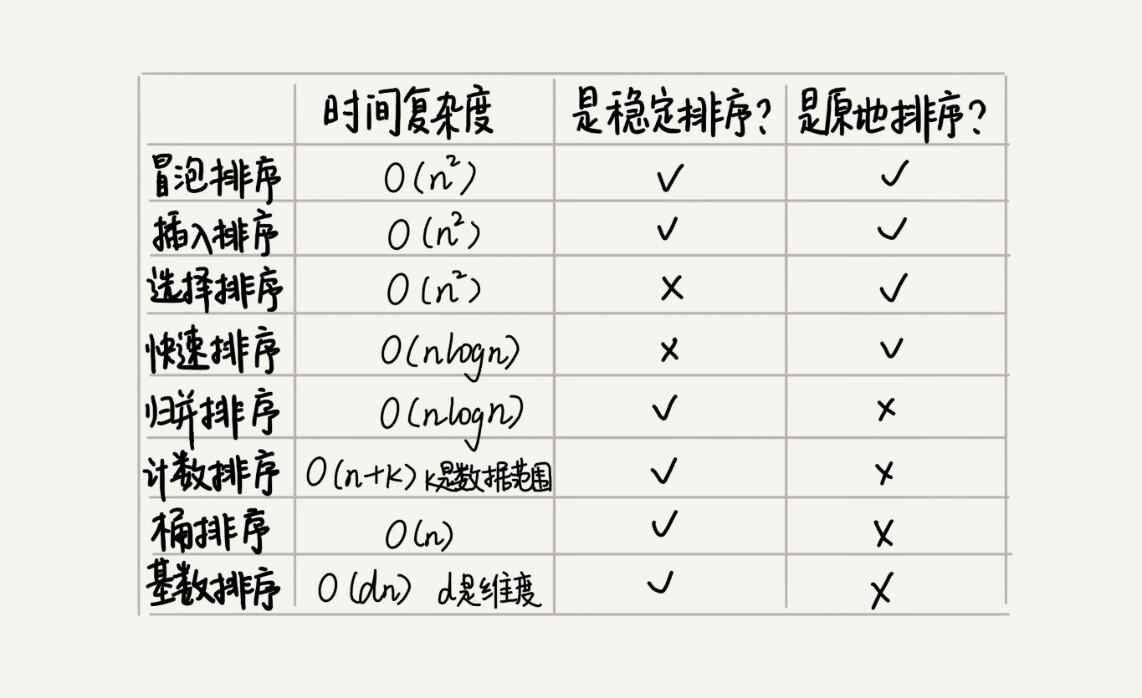
由于线性排序的时间复杂度比较低,适用场景比较特殊。所以要写一个通用的排序函数,不能选择线性排序算法。
如果对小规模数据进行排序,可以选择时间复杂度是O(n²)的算法;如果对大规模数据进行排序,时间复杂度是O(n㏒n)的算法更加高效。所以,为了兼顾任意规模数据的排序,一般都会首选时间复杂度是O(n㏒n)的排序算法来实现排序函数。
时间复杂度是O(n㏒n)的排序算法有归并排序、快速排序,还有堆排序。堆排序和快速排序都有比较多的应用,比如Java语言采用堆排序实现排序函数,C语言使用快速排序实现排序函数。
使用归并排序的情况并不多。快排在最坏情况下的时间复杂度是O(n²),而归并排序可以做到平均情况、最坏情况下的时间复杂度都是O(n㏒n),看起来挺好,但是归并排序不是原地排序算法,空间复杂度是O(n)。如果要排序100MB的数据 ,除了数据本身占用的内存之外,排序算法还要额外再占用100MB的内存空间,空间耗费就翻倍了。
快速排序比较适合来实现排序函数,但是,快排在最坏情况下的时间复杂度是O(n²)。我们得解决这个“复杂度恶化”的问题。
如何优化快速排序?
如果数据原来就是有序的或者接近有序,每次分区点都选择最后一个数据,那快速排序算法就会变得非常糟糕,时间复杂度就退化为O(n²)。这种O(n²)时间复杂度出现的主要原因还是因为我们分区点选的不够合理。
那如何来选择分区点呢?
最理想的分区点是:被分区点分开的两个分区中,数据的数量差不多。
如果粗暴地直接选择第一个或者最后一个数据作为分区点,不考虑数据的特点,在某些情况下,排序的最坏情况时间复杂度就是O(n²)。为了提高排序算法的性能,我们要尽可能地让每次分区都比较平均。
怎么尽可能地做到分区比较平均?这里有两种比较常用、比较简单的分区算法。
-
三数取中法
从区间的首、尾、中间,分别取出一个数,然后对比大小,取这3个数的中间值作为分区点。这样每间隔某个固定的长度,取数据出来比较,将中间值作为分区点的分区算法,肯定要比单纯取某一个数据更好。但是,如果要排序的数组比较大,那“三数取中”可能就不够了,可能要“五数取中”或者“十数取中”。
-
随机法
随机法就是每次从要排序的区间中,随机选择一个元素作为分区点。这种方法并不能保证每次分区点都选得比较好,但是从概率的角度来看,也不大可能会出现每次分区点都选得很差的情况,所以平均情况下,这样选的分区点是比较好的。时间复杂度退化为O(n²)的情况,出现的可能性不大。
快排是用递归来实现的,在学递归的时候知道,递归要警惕堆栈溢出。为了避免快速排序里,递归过深而堆栈过小,导致堆栈溢出,我们有两种解决办法:第一种是限制递归深度。一旦递归过深,超过我们事先设计的阈值,就停止递归。第二种是通过在堆上模拟实现一个函数调用栈,手动模拟递归压栈、出栈的过程,这样就没有了系统栈大小的限制。
//模拟递归函数调用栈事例
//递归方法
private static int Foo(int n){
  if(n<=1){
    return 1;
  }else{
    return n*Foo(n-1);
  }
}
//模拟函数调用栈实现
private static int Foo(int n){
  //使用栈模拟系统栈的行为
  Stack<Integer> systemStack = new Stack<>();
  //back为true,表示递归调用的返回过程;back若为false,表示递归调用的调用过程
  boolean back = false;
  int result=0;
  do{
    if(!back){
      //调用过程
      if(n<=1){
        back = true;
        result = 1;
      }
      systemStack.push(n);
      n--;
    }else{
      //返回过程
      result*=systemStack.pop();
    }
  }while(!systemStack.isEmpty());
  return result;
}
//几个关键点
//使用boolean类型变量back标识递归的调用和返回过程,若back值为true,表示当前的过程为return过程;若back值为false,表示当前过程为call过程。
//在call过程中将每一层使用到的n值放入栈中
//在return过程中将栈中的值一个个取出以和之前一次执行的结果相乘。
//递归的边界是n<=1。
举例分析排序函数
例如:Glibc中的qsort()函数。从名字上看,很像是基于快速排序算法实现的,实际上它并不仅仅用了快排这一种算法。
根据源码会发现,qsort()会优先使用归并排序来排序输入数据,因为归并排序的空间复杂度是O(n),所以对于小数据量的排序,比如1KB、2KB等,归并排序额外需要1KB、2KB的内存空间。这个问题不大。这是一个典型的用空间换时间的技巧。
但是数据量太大的话,比如排序100MB的数据,这个时候用归并排序就不合适了。所以,要排序的数据量比较大的时候,qsort()会改为用快速排序算法来排序。
那qsort()是如何选择快速排序算法的分区点呢?看源码的话就会发现,qsort()选择分区点的方法就是“三数取中法”。
对于递归太深导致堆栈溢出的问题,qsort()是通过自己实现一个堆上的栈,手动模拟递归来解决的。
实际上,qsort()并不仅仅用到了归并排序和快速排序,它还用到了插入排序。在快速排序的过程中,当要排序的区间中,元素的个数小于等于4时,qsort()就退化为插入排序,不再继续用递归来做快速排序,因为在小规模数据面前,O(n²)时间复杂度的算法并不一定比O(n㏒n)的算法执行时间长。
虽然算法的性能可以通过时间复杂度来分析,但是这种复杂度分析是比较偏理论的,要深究的话,实际上时间复杂度并不等于代码实际的运行时间。
时间复杂度代表的是一个增长趋势,如果画成增长曲线图,就会发现O(n²)比O(n㏒n)要陡峭,也就是说增长趋势要更猛一些。但是,在大O复杂度表示法中,我们会省略低阶、系数和常数,即O(n㏒n)在没有省略低阶、系数、常数之前可能是O(kn㏒n + c),而且k和c有可能还是一个比较大的数。
假设k=1000,c=200,当我们对小规模数据(比如n=100)排序时,n²的值实际上比kn㏒n + c还要小。
kn㏒n + c = 1000 * 100 * ㏒100 + 200 远大于 10000
n² = 100*100 = 10000
所以,对于小规模数据的排序,O(n²)的排序算法并不一定比O(n㏒n)排序算法执行的时间长。对于小数据量的排序,我们选择比较简单、不需要递归的插入排序算法。
在qsort()插入排序的算法实现中,也用到了哨兵机制这种编程技巧,虽然哨兵可能只是少做一次判断,但是毕竟排序函数是非常常用、非常基础的函数,性能的优化要做到极致。
内容小结
本篇分析了一下如何来实现一个工业级的通用的、高效的排序函数。在大部分排序函数中,都是采用O(n㏒n)排序算法来实现,但是为了尽可能地提高性能,会做很多优化。
本篇还介绍了下快速排序的一些优化策略,比如合理选择分区点、避免递归太深导致堆栈溢出等等。还分析了下C语言中qsort()函数的底层实现原理。
思考
分析一下Java语言中的排序函数Arrays.sort()都是用什么排序算法实现的呢?有哪些优化技巧?
最后的最后,学习算法要重点理解算法的思路,这其中的思考过程比直接看标准答案来的重要。
